Skalowanie dużego katalogu produktów lub zaawansowanego serwisu ofertowego B2B wymaga kompromisu pomiędzy użytecznością dla człowieka (UX) a zrozumiałością dla robotów wyszukiwarek. Gdy użytkownik wchodzi do kategorii liczącej tysiące pozycji, naturalnie oczekuje możliwości zawężenia wyników: wybiera jednocześnie trzy warianty kolorystyczne, dwa zakresy wymiarów, dostępność w magazynie oraz sortowanie po cenie od najniższej.
Dla silnika bazodanowego to proste zapytanie SQL. Jednak z punktu widzenia robotów indeksujących każda zmiana checkboxa to potencjalnie nowy, unikalny adres URL. Jeśli platforma nie posiada zaimplementowanych barier architektonicznych, rozpoczyna się cichy paraliż widoczności serwisu. W takich scenariuszach niezbędna jest precyzyjna optymalizacja stron, która odetnie robotom dostęp do bezwartościowych ślepych zaułków, skupiając moc obliczeniową wyłącznie na stronach generujących konwersję.
Matematyka katastrofy: Jak 20 filtrów tworzy 1 000 000 adresów URL?
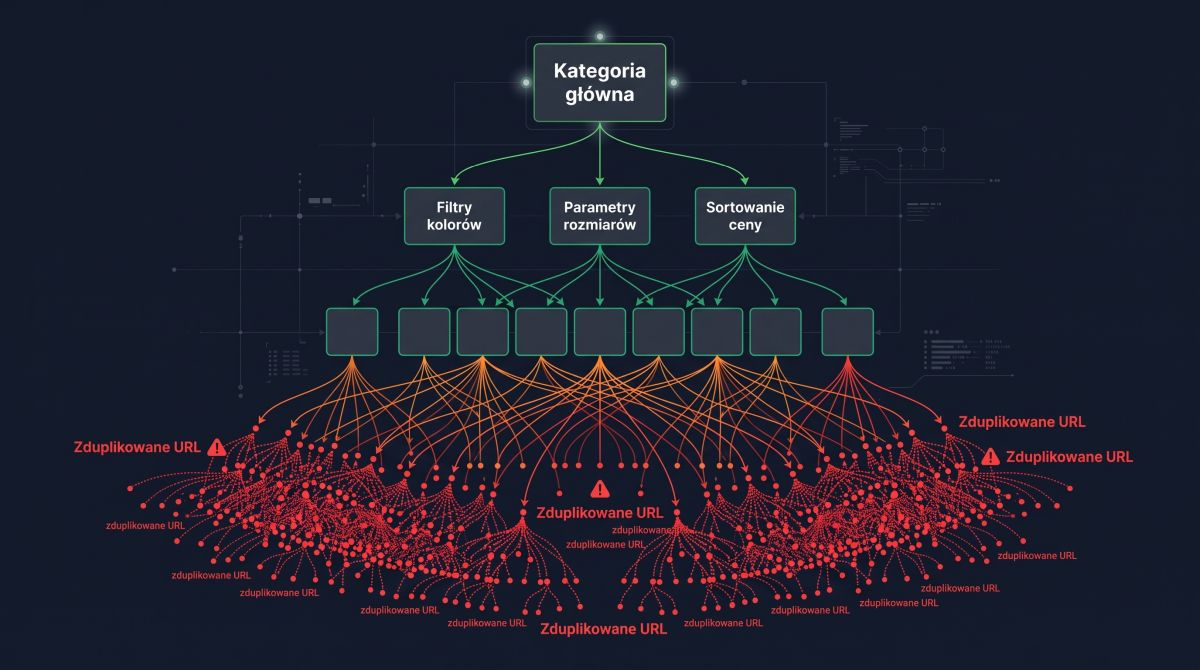
Zjawisko eksplozji kombinatorycznej w filtracji fasetowej to najczęstszy powód, dla którego sklepy o potężnym asortymencie notują gorszą indeksację niż proste strony konkurencji.
Przeliczmy to na prostym przykładzie kategorii z 5 grupami filtrów:
- Kolor (10 opcji)
- Rozmiar (6 opcji)
- Materiał (5 opcji)
- Producent (8 opcji)
- Opcje sortowania i paginacja (10 stanów)
Liczba możliwych permutacji URL w obrębie zaledwie jednej kategorii sięga setek tysięcy:
/kategoria?kolor=czarny&rozmiar=xl&sort=cena_asc&dostepnosc=24h
/kategoria?rozmiar=xl&kolor=czarny&dostepnosc=24h&sort=cena_asc
Jeśli serwer nie standaryzuje kolejności parametrów i pozwala na generowanie odmiennych URL-i dla tej samej zawartości, tworzy podręcznikową duplikację treści (Duplicate Content) na masową skalę. Googlebot wchodząc w taką strukturę, traktuje każdy wariant jako nowy adres do zbadania. W efekcie 85% czasu spędzonego w Twoim serwisie robot poświęca na skanowanie pustych lub niemal identycznych macierzy produktowych.
📌 Warto przeczytać w tym temacie:
Dług technologiczny a bariery indeksacji: Jak audytować błędy blokujące Googlebota?
Mit tagu Canonical: Dlaczego rel="canonical" to za mało?
Wielu deweloperów i tradycyjnych optymalizatorów próbuje rozwiązać problem nawigacji fasetowej jednym ruchem: ustawiając na wszystkich stronach przefiltrowanych tag:
<link rel="canonical" href="[https://domena.pl/kategoria](https://domena.pl/kategoria)" />
To poważny błąd w rozumieniu działania crawlerów.
Tag kanoniczny jest wskazówką dla indeksu, a nie dyrektywą dla crawlera. Oznacza to, że aby Googlebot dowiedział się, dokąd prowadzi link kanoniczny, musi najpierw fizycznie pobrać cały kod HTML podstrony przefiltrowanej, przetworzyć go i zinterpretować. Jeśli Twój serwis generuje 500 000 takich URL-i, robot i tak pobierze każdy z nich, marnując Twój Crawl Budget i zasoby serwera (CPU/RAM). Zanim skończy analizować pętle fasetowe, opuści witrynę, pozostawiając nowe, kluczowe produkty poza indeksem.
Inżynieryjne wzorce radzenia sobie z nawigacją fasetową
Prawidłowe zaprojektowanie architektury filtrów wymaga rozdzielenia dwóch potrzeb: ekspozycji wartościowych fraz długiego ogona oraz hermetyzacji stanów czysto użytkowych.
Oto trzy sprawdzone wzorce technologiczne:
Wzorzec 1: Filtry czysto interfejsowe (AJAX / History API bez linków <a>)
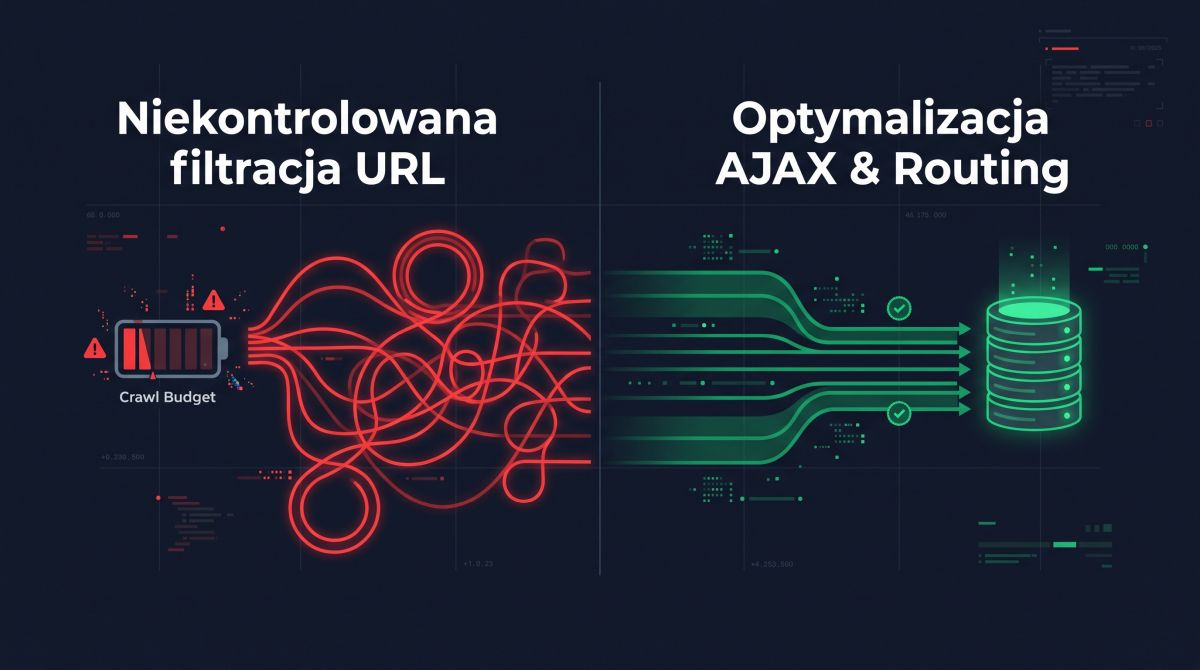
Jeśli dana kombinacja filtrów nie reprezentuje wolumenu wyszukiwań (np. połączenie koloru fioletowego, rozmiaru XXL i sortowania po zniżce), interfejs nie powinien renderować standardowych odnośników <a href="...">. Zmiana stanu filtrów powinna odbywać się asynchronicznie za pomocą JavaScriptu (np. pobieranie JSON przez Fetch API i podmiana widoku produktów) lub poprzez formularze z metodą POST. Brak tagu <a> z atrybutem href oznacza, że crawler nie widzi ścieżki do pobrania i nie wchodzi w pętlę.
Wzorzec 2: Przekształcanie wartościowych filtrów w statyczne Landing Page
Część zapytań fasetowych ma potężny potencjał biznesowy (np. „buty robocze męskie skórzane”). W takim wypadku system nie powinien serwować adresu z parametrem zapytania (?filtr=...), lecz przekształcać go w czysty, statyczny adres URL z własnym klastrem semantycznym:
/buty-robocze/meskie-skorzane/
Taki adres otrzymuje unikalne tagi Title, dedykowany nagłówek H1, własny opis kategorii i staje się pełnoprawną podstroną w architekturze Topic Clusters.
Wzorzec 3: Hermetyzacja w robots.txt i dyrektywy Noindex
Parametry czysto techniczne, które nie wnoszą wartości rankingowej (sortowanie, paginacja powyżej określonego poziomu, widoki siatki/listy, filtry zakresów cenowych), muszą być bezwzględnie zablokowane przed crawlerami za pomocą dyrektywy Disallow w pliku robots.txt:
User-agent: Googlebot
Disallow: /*?*sort=
Disallow: /*?*price=
Disallow: /*?*limit=
Blokada w robots.txt zabrania robotowi pobierania zasobu, co natychmiast uwalnia Crawl Budget i kieruje uwagę algorytmu na właściwe strony sprzedażowe.
Porównanie podejść: Jak zarządzać adresami z filtracji?
| Metoda kontroli | Wpływ na Crawl Budget | Indeksacja treści | Kiedy stosować? |
| Brak kontroli (Status Quo) | Krytyczny drenaż budżetu, ryzyko paraliżu indeksacji. | Masowy Duplicate Content i kanibalizacja. | Nigdy – to podręcznikowy błąd architektoniczny. |
| Sam tag Canonical | Znikomy – robot nadal pobiera każdy adres URL. | Ogranicza duplikację w SERP, ale nie ratuje budżetu. | Jedynie jako dodatkowe zabezpieczenie, nie jako fundament. |
| Blokada w robots.txt | Maksymalna ochrona – bot fizycznie nie pobiera zasobu. | Strona nie jest indeksowana, ale może gromadzić linki. | Parametry sortowania, paginacji, zakresów cenowych. |
Architektura AJAX / Brak tagów <a> | Pełna kontrola – bot nie widzi ścieżek URL do pętli. | Treść dynamiczna widoczna wyłącznie dla użytkownika. | Złożone wielokrotne filtry bez popytu w wyszukiwarce. |
| Statyczne URL-e (Rewriting) | Celowe wykorzystanie budżetu na strony konwertujące. | Pełna indeksacja jako osobny landing page SEO. | Popularne kombinacje z twardym wolumenem wyszukiwań B2B. |
Zarządzanie nawigacją fasetową to operacja na otwartym sercu serwisu. Wdrożenie wymaga ścisłej współpracy inżyniera SEO z architektem backendu, ale rezultat w postaci natychmiastowego odblokowania indeksacji nowych produktów zwraca się wielokrotnie.