Budowanie widoczności organicznej często przypomina napełnianie dziurawego wiadra. Inwestujesz w wysokiej klasy artykuły, budujesz kosztowny profil linków zwrotnych, ale pozycje w wyszukiwarce ani drgną. W 90% dużych serwisów e-commerce i witryn korporacyjnych problem nie leży w braku autorytetu, ale w architekturze kodu.
Dług technologiczny, potęgowany przez kolejne zmiany doklejane latami przez różne zespoły deweloperskie, tworzy niewidzialny mur dla algorytmów Google. Aby go zburzyć, niezbędny jest rygorystyczny Audyt SEO połączony z techniczną weryfikacją frontendu i backendu.
Anatomia błędu: Kiedy Googlebot odbija się od ściany
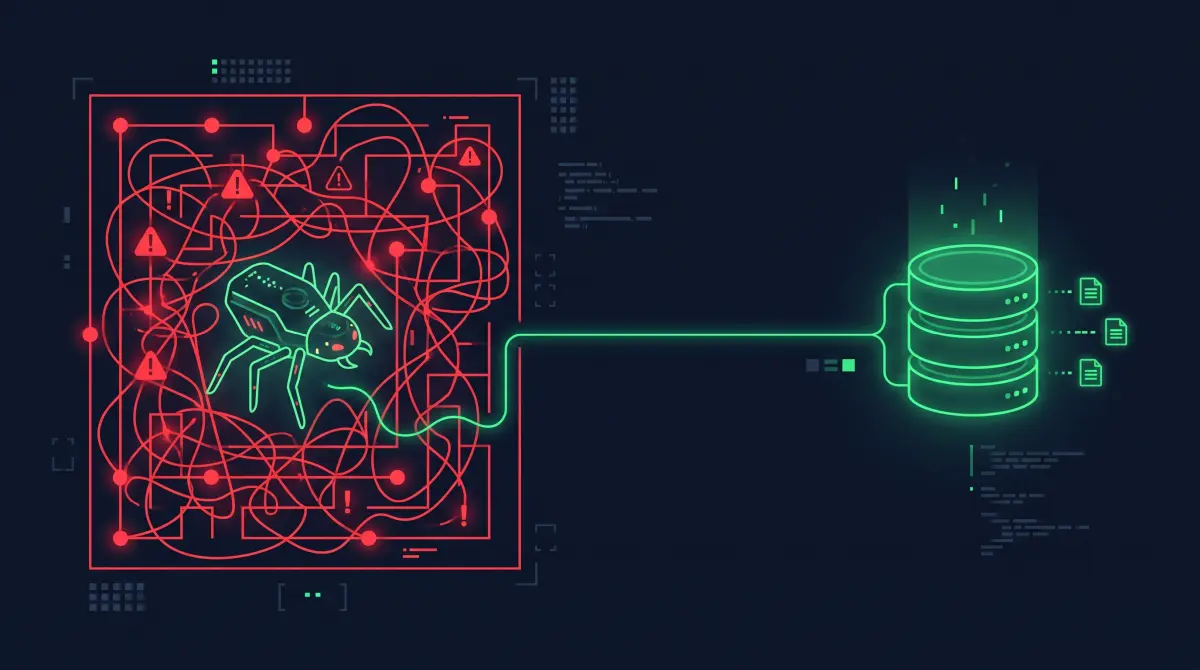
Wyszukiwarki działają na podstawie precyzyjnego budżetu zasobów (Crawl Budget). Google nie będzie w nieskończoność czekać, aż Twoja strona "poułada" w przeglądarce ciężkie skrypty. Jeśli natrafi na bariery indeksacji, po prostu przerywa skanowanie i porzuca niezindeksowane podstrony.
Oto trzy najczęstsze, inżynieryjne przyczyny zablokowanej indeksacji:
1. Pułapka renderowania po stronie klienta (Client-Side Rendering)
Większość nowoczesnych aplikacji (React, Vue, Angular) domyślnie generuje pusty kod HTML (<div id="root"></div>), a cała treść ładowana jest asynchronicznie przez JavaScript już w przeglądarce użytkownika. O ile użytkownik z szybkim smartfonem tego nie zauważy, o tyle Googlebot musi przenieść taki adres do kolejki renderowania (WRS - Web Rendering Service). Oznacza to, że Twoja kluczowa usługa może czekać na pojawienie się w wynikach wyszukiwania dniami, a nawet tygodniami.
2. Crawler Traps (Pułapki na roboty) i nawigacja fasetowa
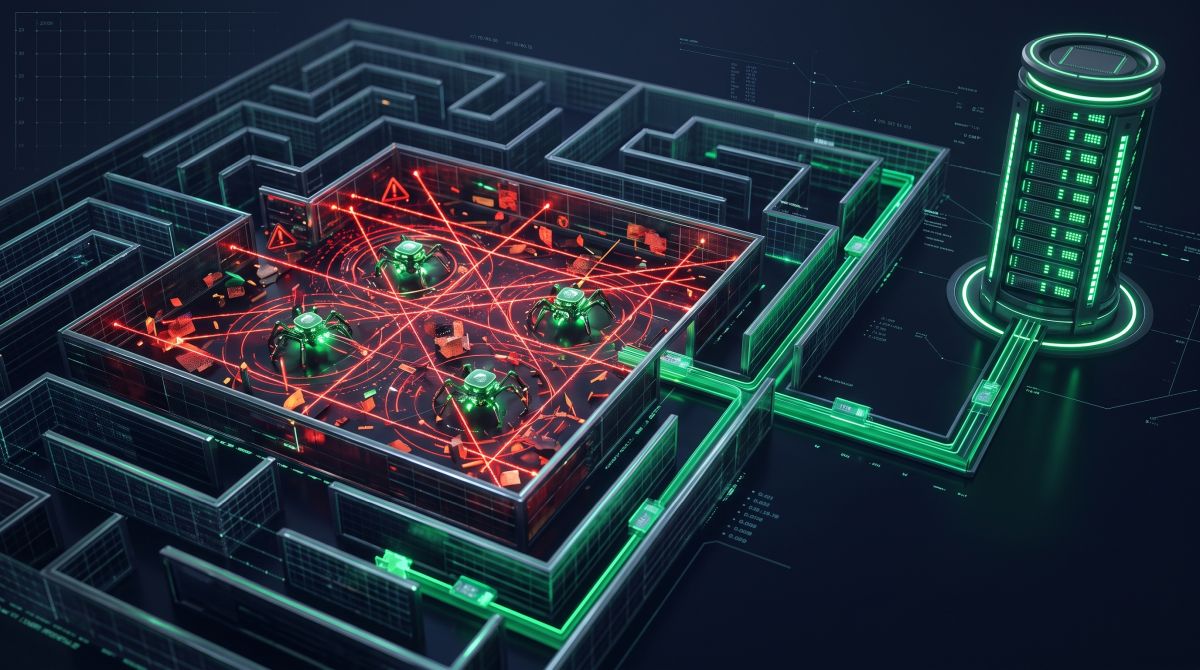
W dużych serwisach B2B i sklepach internetowych, filtry (np. sortowanie po cenie, rozmiarze, kolorze) generują miliony unikalnych parametrów w adresach URL (np. ?sort=price_asc&color=black). Jeśli logika tagów canonical i pliku robots.txt nie jest hermetyczna, Googlebot utknie na skanowaniu 100 000 pustych stron wynikowych, całkowicie ignorując kaloryczne strony produktowe. To podręcznikowy przykład przepalenia Crawl Budgetu.
3. Łańcuchy i pętle przekierowań
Wieloletni dług technologiczny często objawia się w mapach przekierowań. Zmiana CMS-a 3 lata temu, przeniesienie serwisu rok temu i nagle, by dotrzeć z adresu A do adresu B, bot musi pokonać trzy przekierowania 301, które często zapętlają się w błędach.
📌 Warto przeczytać w tym temacie:
Crawler Traps i pętle w filtracji fasetowej: Jak nieskończone adresy URL drenują Twój Crawl Budget?
Wdrożenie inżynieryjne: Leczenie przyczyn, a nie objawów
Zamiast maskować problemy przez zgłaszanie pojedynczych adresów URL w Google Search Console (objawy), należy zrestrukturyzować to, jak aplikacja dostarcza kod (przyczyny).
Migracja na SSR lub SSG:
Jedynym definitywnym rozwiązaniem problemu z indeksacją aplikacji opartych na JS jest wdrożenie Server-Side Rendering (SSR) lub Static Site Generation (SSG). Przeniesienie architektury na frameworki takie jak Astro, Next.js czy Nuxt sprawia, że serwer wysyła do wyszukiwarki gotowy, statyczny plik HTML. Kod jest "czytelny" natychmiastowo, a czas odpowiedzi serwera (TTFB) oraz kluczowa metryka LCP (Largest Contentful Paint) drastycznie spadają.
Analiza Logów Serwera:
Aby udowodnić zespołowi IT, gdzie dokładnie rozbija się Googlebot, SEO musi zrzucić logi serwera (pliki Apache/Nginx). Analiza tych danych czarno na białym pokazuje, jakie kody HTTP (np. błędy 500, 404, 301) zwraca serwis wyłącznie dla user-agenta "Googlebot" i które filtry konsumują 80% zasobów.
Najczęstsze błędy wdrożeniowe i ich skutki
Decydenci bardzo często mylą powierzchowną kosmetykę strony z głęboką diagnozą techniczną.
| Podejście powierzchowne (Błąd) | Podejście inżynieryjne (Skuteczne) |
Odświeżanie mapy witryny (sitemap.xml) przy każdym spadku indeksacji. | Analiza logów serwera i lokalizacja faktycznych ścian architektonicznych. |
| Upychanie słów kluczowych do treści na stronach typu Single Page Application (SPA). | Zmiana sposobu renderowania (SSR/SSG), by kod tekstowy znalazł się w pierwotnym DOM. |
Ręczne blokowanie setek parametrów filtrów w pliku robots.txt. | Wdrożenie czystej architektury nawigacji fasetowej opartej na wstrzykiwaniu skryptów bez tagów <a> i logicznym użyciu tagów canonical. |
Ignorowanie długu technologicznego to koszt, który rośnie z każdym miesiącem. Kod serwisu to kręgosłup Twojej widoczności w sieci. Bez audytu i twardych wytycznych architektonicznych, żaden budżet na content marketing nie przyniesie przewidywalnego zwrotu z inwestycji (ROI).